灵
灵机 FeedHub
🌙
← 返回 AI 资讯大厅
📰 今日早报 ↗
← 返回 AI 资讯大厅
11月6日 08:00
论文
信源:
vLLM 官方博客(RSS)
· 👁️ 18077 次研读
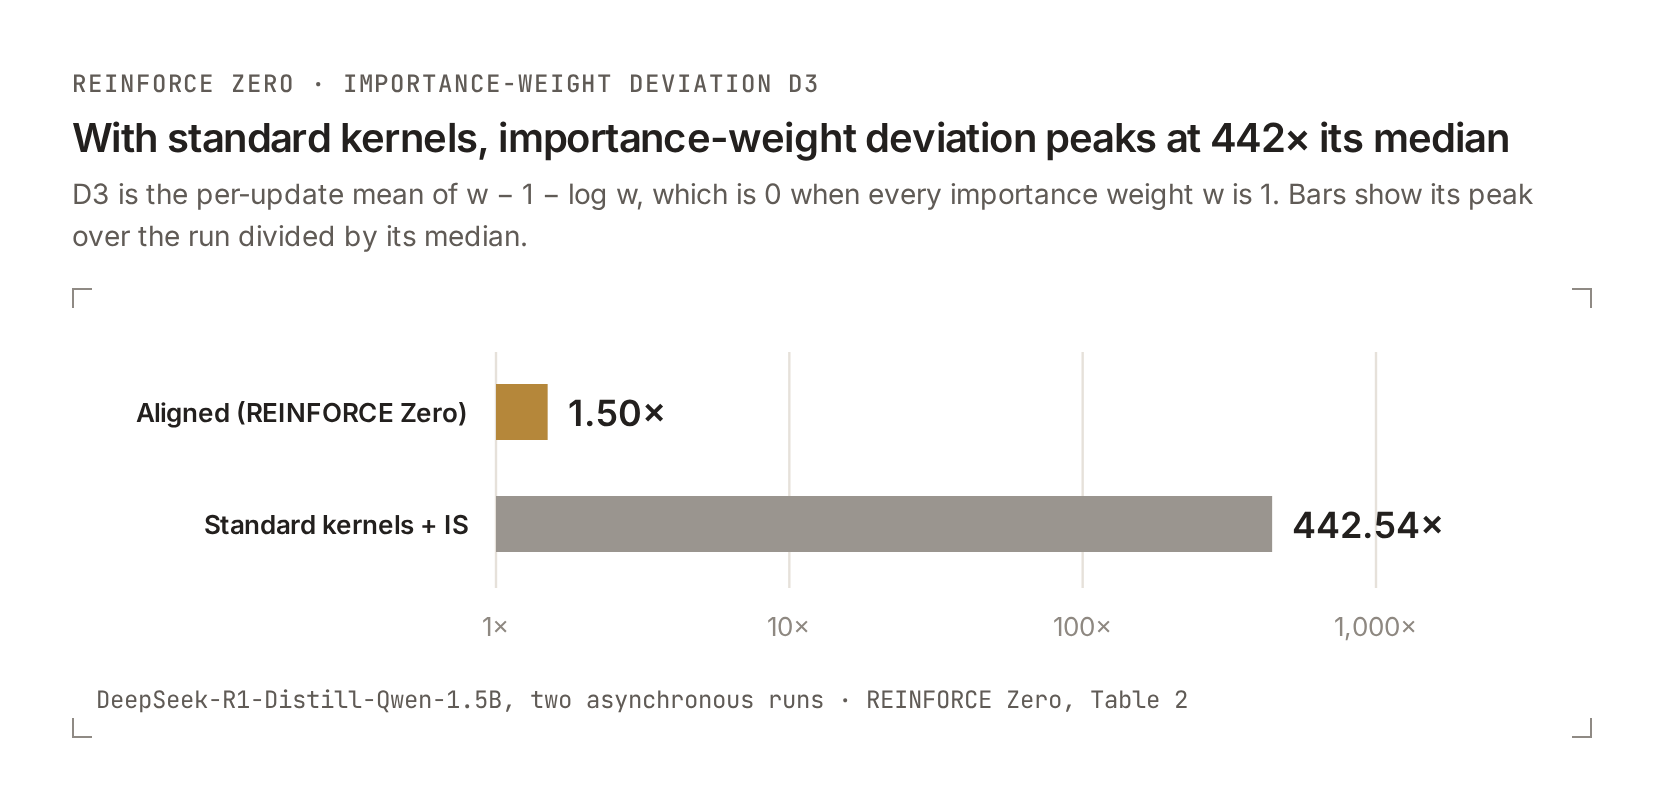
vLLM 与 NVIDIA Research 发布 REINFORCE Zero,实现零失配异步 RL 训练
💡 灵机 AI 深度洞见与核心提炼
vLLM 博客介绍 NVIDIA Research 与 Inferact 的 REINFORCE Zero 方法:对齐 rollout 与训练内核后,用不加截断的 token 级重要性采样即可稳定异步 RL。
信源媒体:
vLLM 官方博客(RSS)
访问出处网页 ↗
阅读原文出处 ↗
📋 复制分享链接
← 返回大厅